Go 学习笔记
GoLang 知识点随笔,学习自尚硅谷韩顺平视频课
Hello World
– GOPROJECT
– src
– gocode
– project01
– package
上面为Go项目的文件结构,GOPROJECT 目录需要在用户变量中设置为GOPATH的值,此外 Go 还需要添加 GOROOT 环境变量
执行 go build 可以将源码编译为exe文件,而执行 go run 可以直接运行源文件,类似于脚本语言(其实是先编译再执行)go build -o rename.exe name.go 可以命名生成的可执行文件
1 | Tips: |
引入多个包:
1 | import ( |
Dos常见指令
dir查看当前目录cd dir_name移动到文件夹cd D:或者直接D:移动盘符
md dir_name创建文件夹rd /q/s dir_name强行删除文件夹,且不询问echo content > filename.txt将内容添加到文件中,没有文件则创建copy filename dir_name\re_filename拷贝文件,且可以改名move filename dir_name\re_filename移动文件,且可以改名del filename删除文件, 可以用通配符*cls清屏exit退出Dos
变量
声明的三种方式:
- 指定变量类型,声明后会赋默认值(0或空串)
var i int - 根据值自动判断变量类型
var j = "sss" - 省略 var,但是使用 := 赋值,变量不能用已经声明过的
name := "tom"
同时定义多个变量: var n1, n2, n3 int, 变量也可以不同类型 var n4, n5 = 18, "hehe", 也可以用 := 的方式
全局变量:在函数外声明的变量就是全局变量,除了上面的方式外(:=方式不行),还可以用这种方式:
1 | var( |
常量
用const定义,定义时必须初始化,不能修改,只能是基本数据类型
const identifier [type] = value
value中不能有变量、函数等
const(
a = 1
b = ‘c’
)
a的值是0,下面每行依次加一
const(
a = iota
b
c, d
)// 0,1,2,2
首字母大写影响访问范围
数据类型
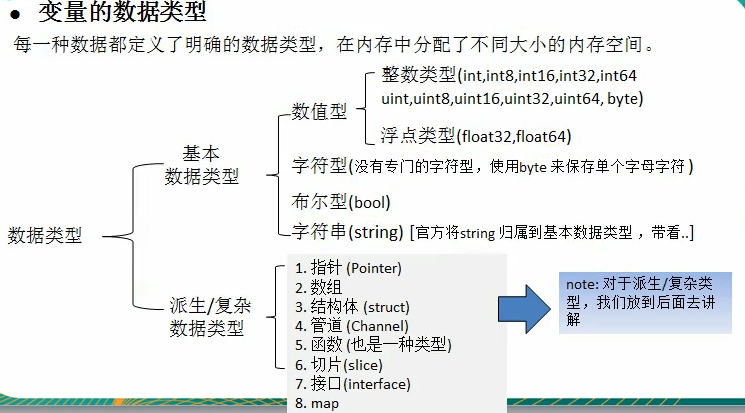
uint为无符号整数
fmt.Printf("%T",name)可以输出变量类型- unsafe.Sizeof(name) 可以得到变量占用的字节数
- 值类型(栈区):int, float, bool, string, 数组, 结构体struct
- 引用类型(堆区):指针,slice切片,map,管道chan,interface
type 别名 类型 给类型起别名,但两个应该看作不同类型
整数
超出范围会报错 overflow
有符号整数表示范围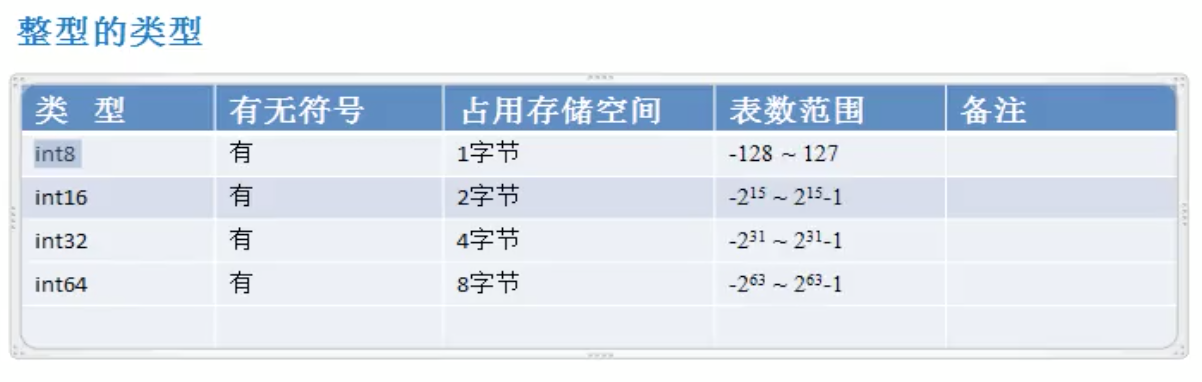
无符号整数表示范围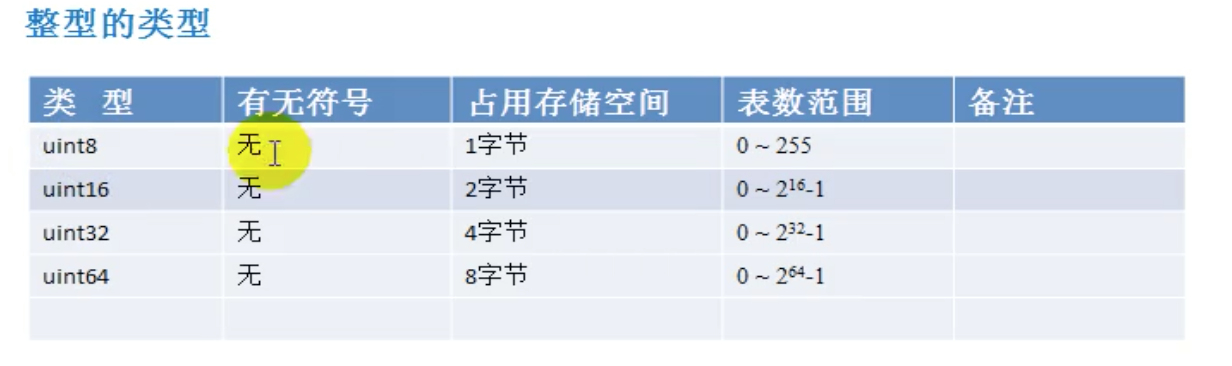
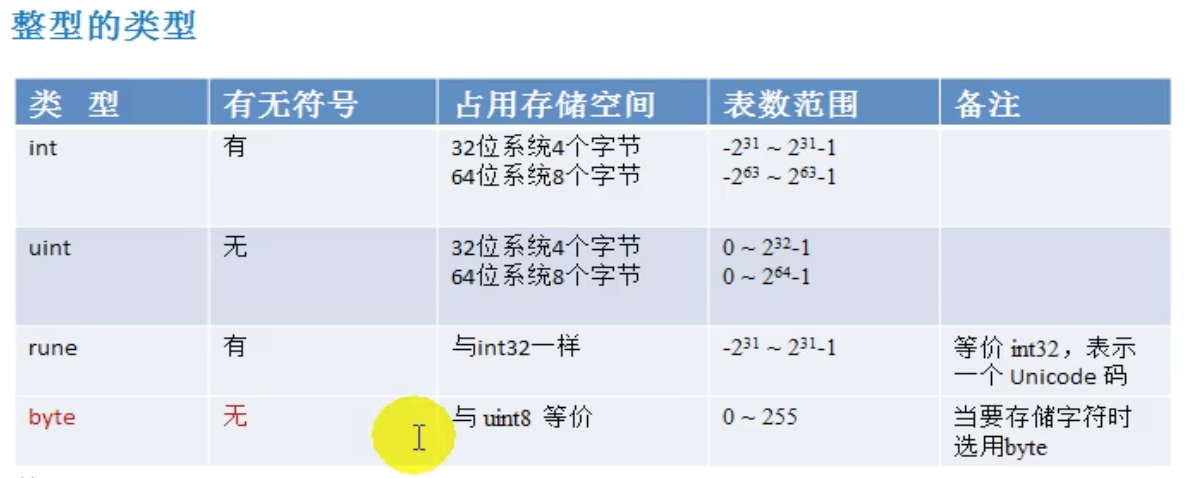
整形默认声明为int类型
浮点数
float32 单精度,float64 双精度
- 符号位+指数位+尾数位,可能有精度损失
- float64为默认声明类型
- 可以将0.123缩写为.123,还可以用科学计数法 1.23E10, 1.23e-2
- 用%f输出小数,使用%v不会有多余小数(如11.00000)
- %a.bf 会输出整数宽度为a位,小数精度为b位的浮点数
字符
- Go没有专用字符类型,一般用byte变量
- 字符用单引号包裹
- 字符串是由字节组成的,采用UTF-8编码,汉字三个字节
- 直接输出字符,输出的是码值(’a’ -> 97),使用%c可以输出字符
- 可以将字符赋给int变量,也可以使用%c将int值转换对应码值的字符(可以用此保存中文字符等)
- 字符类型可以进行运算,相当于一个整数
布尔类型
bool,占一个字节,只许取true和false,默认值为false,可以用%t输出
字符串
- 采用UTF-8编码
- 字符串一旦赋值不可通过下标更改字符,但可以重新赋值
- 字符串用双引号会识别转义字符,且直接换行会报错,用反引号``会原样输出文本
- 可以用加号进行拼接,换行时加号必须留在上一行末尾(Go会在行尾自动添加;)
- 默认值为空串””
- 用%v原值输出,用%q自带双引号
- 可以强制转换为 []byte 、[]rune(支持中文)格式
类型转换
- 数据类型必须显式转换,
要转类型(变量),强制转换溢出不会报错 - 跟常量运算,结果的类型保持不变
转换为 string:
fmt.Sprintf("%t",b)- strconv包下的函数,如 FormatInt(num, 进制), Itoa(int)
转回基本类型:
strconv包下的 ParseInt(),转换失败会返回0、false
指针
- &i 可以输出地址
var s *int=&i- 用*获取指针储存地址的值
命名规则
- 可以使用字母数字下划线,单独用下划线命名表示省略变量
- 包名要跟目录名保持一致
- 变量、函数、常量要采用驼峰法 aaaBbbCcc
- 如果变量、函数、常量名首字母大写,表示共有,可以被其他包访问(导包地址用/,自动从gopath/src 下查找)
- 不能使用保留关键字作为变量名,最好不要用预定义标识符(基本数据类型、内嵌函数)作为变量名
运算符
算术运算符
- 10 / 4 的结果为2,舍弃掉了小数部分不会四舍五入,需要把其中一个变成小数才能得到小数
- 被取模数a的符号决定结果符号(a%b=a-a/b*b)
- Go只有后置++,且只能当作独立语句,不能放进表达式中
逻辑运算符
&& 和 || 都有短路机制,只要第一个为false或true,后面的就不再判断
赋值运算符
- <<= 左移后赋值
- ^= 按位异或后赋值
- &= 按位与后赋值
- |= 按位或后赋值
按位运算符
- 【<<】 左移一位,符号位不变,低位补0
- 【>>】 右移一位,符号位不变,高位补符号位
- ^ 按位异或
- & 按位与
- | 按位非
⚠ 按位运算是通过补码运算的。正数和0的原码、反码、补码相同,负数的反码等于除符号位外取反,负数的补码等于反码+1
优先级
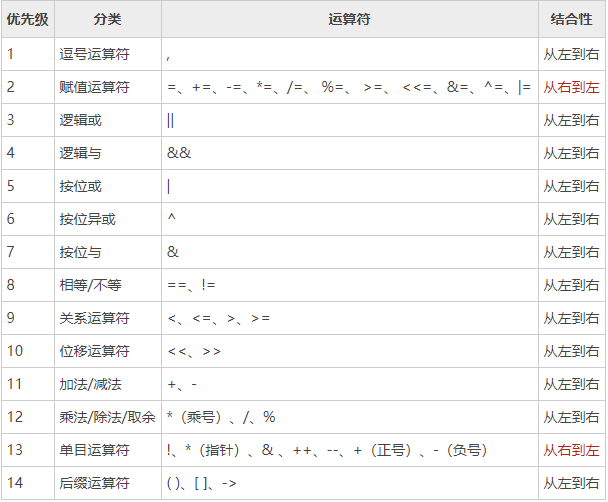
键盘输入
fmt包的 Scanf("%s %t", &name, &isPassExam) Scanln(&name) ,参数要传地址才能修改外部变量
如果类型不符,就会保持原来的值
进制
- Go 中不能直接使用用二进制,用%b输出
- 八进制以0开头,十六进制以0x开头
- 十转换为其他进制:除n取余,然后把每部余数倒过来
流程控制
选择
1 | if 定义变量; 条件表达式 { |
- switch 分支后不需要break,因为默认就有
- case后可以写多个表达式,匹配一个即可
- case和switch表达式数据类型保持一致
- case表达式,如果是常量字面量,则不能重复
- switch后也可以不带表达式,类似if-else,case后用条件判断表达式
- switch后可以定义变量,需要加分号
- case语句块后添加 fallthrouth 穿透语句,则会继续执行下一个case分支
- 还可以用于判断接口指向的数据类型
1 | switch 表达式 { |
判断少数的具体值,switch简洁高效,,对区间和结果为bool的判断,if范围应用更广
循环
GO中没有while和do-while
1 | for 循环变量初始化;循环条件;循环遍历迭代 { |
还可以去掉初始化和迭代语句,分号可以不写:
1 | 循环变量初始化 |
还可以全都不写 for{循环语句} 同样可以不加分号
for中还有for-range方法,可以遍历字符串和数组,这种方法字符串是按字符遍历的
1 | for index, val := range str { |
流程控制
在for循环前使用 label1: 设置标签,break label1 可以跳出该层循环
continue结束本次循环,也可以使用标签
goto label1 可以跳转到任意位置
return 会退出当前函数和方法
函数
1 | func 函数名(形参名 类型) (返回值类型){ |
包
- 包的原理就是不同的文件夹,每一个文件必须属于一个包,GO以包的形式管理文件和项目目录结构
- 导入的是文件夹路径,文件夹下有包,包名一般与目录名一致
- 引用路径前可以写别名,但原名就不能使用了
- 编译项目时必须要有main包
函数基本使用
- 在调用函数时,会为函数分配一个新的栈(基本数据类型)空间,局部变量互相独立
- 基本数据类型和数组、结构体是值拷贝方式传递参数
- 函数可以返回多个值,如果不想接受用_忽略
- GO不支持重载
- 函数也是数据类型,可以赋值给变量,也可以做形参,函数的数据类型为 func(参数类型) 返回值类型
func(int, int) int - 接上,可以为函数类型起别名使用
- 返回值可以命名,然后直接当变量使用,无需return特定值
- 支持可变参数,参数名… 类型,类型是切片,可变参数只能放在最后
- 形参可以 n1, n2 int 这样
init函数
每一个源文件可以包含一个,init会在main执行前被调用,但晚于全局变量定义
被引入包的全局变量和init先执行
匿名函数
- 定义时直接调用,只能用一次
func(形参) 返回值{}(实参) - 调用时赋给变量
- 全局匿名函数,赋给全局变量
闭包
一个函数和与其相关的引用组成的一个整体(比如函数和使用的外部变量,变量只初始化一次,相当于类)
1 | //没后缀加上后缀 |
defer
在函数执行完毕后及时释放资源,比如在打开文件和数据库后马上 defer file.close()
defer存在的这行语句会入栈,函数执行完毕后按先入后出的顺序执行,defer将语句入栈时,也会将相应的值拷贝入栈
作用域
在函数外定义的是全局变量,在函数内定义的是局部变量,局部变量优先级大,在代码块if for中定义的变量外部无法调用
全局变量不能用:=形式(执行语句,等价于定义和赋值两句话)
常用的系统函数
字符串函数
- 字符串长度 按字节,中文三个字节 len(str)
- 将字符串转为切片,可以按字符遍历含中文字符串 []rune(str)
- 字符串转整数 strconv.Atoi(str)
- 整数转字符串 strconv.Itoa(int)
- 转为byte数组 []byte(str)
- byte数组转字符串 string([]byte{})
- 将十进制转为其他进制,返回字符串 strconv.FormatInt(int, base)
- 查找子串 strings.Contains(str, substr)
- 统计子串数量 string.Count(str, substr)
- 不区分大小写比较字符串相等 strings.EqualFold(str1,str2)
- 返回子串第一次出现的位置,没有返回-1 strings.Index(str,substr)
- 返回子串最后出现的位置 没有返回-1 string.LastIndex(str,substr)
- 将指定的子串替换成其他子串,并返回新串 string.replace(str,before,after,n) n为替换的个数,-1全替换
- 将字符串按某字符拆分为字符串数组 strings.Spilt(str, char)
- 大小写转换 strings.ToLower(str) strings.ToUpper(str)
- 去除两边空格 strings.TrimSpace(str)
- 去除两边指定的一些字符 strings.Trim(str, sstr) 去掉左边或者右边TrimLeft TrimRight
- 判断是否以某字符串开头结尾 strings.HasPrefix(str, substr) HasSuffix(s,ss)
时间函数
- 获取当前这一时刻的时间,静态变量, time.Now(),返回time.Time类型
- 通过Time类的Year(),Month(),Day(),Hour(),Minute(),Second()等函数,可以获得具体的年月日时分秒,月份可以用int()强转为数字
- 格式化日期和时间
- 传统方式Printf或者Sprintf(返回字符串) 加上 %d
- Time类的Format(“2006-01-02 15:04:05”) 数字是固定的,可以自由组合或者省略
- 时间常量,time包中的 Nanosecond,Microsecond,Milisecond,Second,Minute,Hour等,GO以纳秒为单位,这些只能跟整数操作
- 休眠一段时间 time.Sleep(time.Duration)
- 获取1970.1.1到现在的时间戳,Time类的 Unix()和UnixNano()
内置函数
不许导包就能使用
- len(变量) 求长度
- new(type) 为值类型分配内存,并返回一个指向该值的指针
- make 为引用类型分配内存
其他函数
- 生成随机数:设置种子 rand.Seed(time.Now().UnixNano()),生成[0,n)的随机数 rand.Intn(n)
- 格式化字符串:fmt.Sprintf(“%v”, 变量) 返回格式化字符串
- 排序:sort.Ints(数组或切片)
- 序列化 encoding/json.Marshal(结构体) 返回byte数组和错误信息
- 命令行参数 os.Args string切片,保存命令行输入的参数
- 接上,可以用 flag.IntVar(target *int, commend string, defualtValue int, help string) 和 flag.StringVar() 获取 -p xx 形式的参数,然后要调用 flag.Parse()
错误处理
defer 后调用错误panic处理匿名函数,recover()获取到异常
1 | defer func() { |
自定义错误:
- errors.New(“错误说明”) 会返回一个error类型的值,表示错误,一般用于发生错误时作为返回值抛出错误,调用函数时判断是否返回值并处理错误
- panic内置函数,接受一个空接口类型参数,可以输入error,输出错误信息并退出程序
数组和切片
数组
数组可以存放多个同一数据类型,是值类型,数组定义时把[]放在类型前,如 [3]int,可以直接输出数组内容(因为是值类型)
&数组名就是第一个元素的地址,也是数组的地址,数组中元素的地址是连续的
初始化方式:
- var a [3]int = [3]int {1,2,3} //可以创建空数组,或者直接省略=后面的初始化,但是长度必须为常量
- var a = [3]int {1,2,3}
- var a = […]int {1,2,3}
- var a = [3]int {1:1, 0:2, 2:3} //指定元素对应下标
- a := [3]int {1,2,3}
遍历
1 | for index, value := range arr { |
index 和 value 可以改名,可以用_省略
默认值按数据类型为0,false,””
数组是值类型,所以传入函数中会进行值拷贝,数组间互不影响;如果想要传递引用,需要用指针,然后取值 (*arr)[0] 或者直接 arr[0]
长度也是数据类型的一部分,传参时要考虑数组长度, 长度只能是常量
切片
切片slice长度可变,是数组的引用,引用类型,切片定义方式 var name []int
slice直接输出结果也是元素内容,而不是地址;len(slice)可求长度;切片可容纳的最大个数(容量)动态可变,可用cap(slice)求得
slice底层是结构体,由元素起始地址,长度,容量三部分构成
创建切片:
- 利用已存在的数组
slice := arr[0:3]引用到数组arr下标[0,3)的元素,不包含终止下标,如果开始下标为0或者结束下标为len(arr)可以省略为 arr[:3] arr[2:] arr[:] var slice []int = make([]int, length, cap)cap可以省略- 直接指定数组
var slice []int = []int{1,3,5}
方法一引用已有数组,程序员可见;方法二,make创建一个数组,由切片维护,程序员不可见
可以从切片切片
修改切片的内容,原数组也会改变
slice = append(slice, elem1, elem2…) 向切片末尾追加元素,返回追加后的新切片(扩容还是修改长度都要修改slice结构体本身),也可以追加切片,切片名后必须带…
copy(target, origin) 从一个切片拷贝切片内容,从0开始覆盖target的数组,且拷贝的内容最多只有target的len个
字符串也可以切成字符串切片,字符串结构跟切片类似,但想要修改内容需要先强制类型转换为[]byte然后转回字符串,如果有中文,可以强转为 []rune (int32)切片
二维数组
[行][列]类型,声明后默认值为0,不用必须初始化
初始化方式同一维数组 var arr [2][3]int = [...][3]int{{1,2,3}, {4,5,6}}
for-range的value是一个一维数组
Map
var name map[keytype]valuetype,声明不会分配内存,必须要初始化(如make)后才能使用
slice、map、function等不可以用==的不能当key
初始化: a = make(map[keytype]valuetype, len) //len可省略
赋值: a[key]=value
创建时初始化: var a map[key]value = map[key]value{“a”:”b”,}
重复赋值会覆盖原值,map是无序的(新版有序)
delete(map, key) 如果存在则删除键值对,要一次性删除只能逐个遍历删除或者重新赋值一个空map
value, findRes := map[key] 如果值存在,findRes为true
map要用for-range遍历
也可以用len()求长度
map可以组成切片,能够通过append动态增加,声明长度为n说明切片中有n个需要初始化的空map
map 初始化后会动态扩容,不需要向切片一样append
结构体
GO实现了面向对象编程OOP,struct地位与其他语言的class相同
定义结构体:
1 | type Typename struct{ |
结构体和字段首字母大写,说明可以在包外使用;首字母小写,包外不能创建对象,需要工厂函数才能正常使用
结构体是值类型,复制、传参时是值拷贝
结构体中字段在内存中是连续的,引用类型指向的值不一定连续
值类型字段默认为零值,引用类型字段需要先make才能使用
创建实例方式:
var name Type,修改属性:name.FieldName = "emmm"var name Type = Type{FieldName:"aaaa"}或者类型推导name := Type{"aaa",12}后者初始化要按照字段定义顺序var name *Type = new(Type)(*name).Field 或者 name.Fieldvar name *Type = &Type{}
和其他结构体类型转换必须要有完全相同的字段(名字、个数、类型)
可以使用type重新定义(别名),两者被认为是不同类型,但是可以强转 type newName oldName
在字段加上tag,tag可以通过反射获取,便于进行序列化(将字段名小写等) Name type json:"name"
方法
方法是作用在指定数据类型的,自定义类型都可以有方法,不仅限struct,int等起别名后也可以绑定方法
1 | //与Type类型绑定的方法,方法声明在结构体外 |
方法只能通过Type的实例调用,调用时会将实例也作为参数传入方法,但是值拷贝方式,无法修改外面调用的实例本身
如果要使用实例的指针,func (n *Type) name(){} 需要通过地址调用:(&t).name(),但也可以直接t.name()
传地址效率更高
如果方法指定的实例是 t Type,使用地址也可以调用 (&t).method() ,但是方法内实例t仍然是值拷贝而不是指针,不影响外面的实例,反之也成立,关键是看接收者要接受的是什么。例子如下:
1 | type Stu struct { |
方法首字母大小写同样影响其他包访问权限
如果实现了String()方法,打印时会默认调用,如果方法要求实例传指针,Print函数必须传入实例的地址
可以用 t := &T{} 创建指针并初始化
面向对象特性
封装
定义:将字段和对字段的操作封装在一起,数据被保护在内部,程序的其他包只有通过被授权的方法才能对字段进行操作
实现方法:将结构体和字段首字母小写,然后设置一个工厂模式的函数,首字母大写,然后设置首字母大写的Get和Set方法
继承
如果一个结构体嵌套了一个匿名结构体(只写结构体名不写变量名),那么结构体就能调用匿名结构体的字段和方法(不管大小写),从而实现了继承
调用匿名结构体成员: 实例.匿名结构体.成员 ;或者简写为 实例.成员,简写后编译器会先查找结构体本身,如果没有就依次查找基类,如果两者有同名字段和方法采用就近访问原则
父类方法调用的是父类自己的方法和字段
在包外无法继承小写结构体,也无法调用匿名结构体中的小写方法和小写字段
1 | type Student struct { |
如果嵌入了多个匿名结构体,且有相同字段或方法,但结构体本身没有,访问时必须明确指定匿名结构体
也可以在创建变量时直接对匿名结构体的字段进行赋值
1 | //方式一 |
匿名结构体也可以用指针
结构体的匿名字段类型是基本数据类型,也可以通过 变量.基本类型 调用,不能有两个同类型匿名字段
接口
接口定义了一组不需要实现的方法(没有方法体),并且不能包含常量。
接口不需要显式的实现,自定义类型包含接口中的所有方法,就是实现了该接口。
接口可以作为参数传入函数和方法。
1 | type USB interface { |
接口本身不能创建实例,但可以指向一个实现该接口的自定义类型的变量
只要是自定义类型,就可以实现接口,不仅是结构体
接口也可以继承其他接口(与结构体继承方式相同),实现改接口需要将其亲代接口也实现
接口是引用类型,与结构体不同
空接口没有方法,任何数据类型都实现了空接口,也可以把任何类型变量赋给空接口实例,空接口本身也是数据类型,可以定义变量 var a interface{}
不能同时继承具有相同方法名,但方法形参、返回值不同的接口
如果指针类型实现了接口,那么只能将地址赋给接口变量,而不能用普通类型变量 func (a *A) method(){} var interface Interface = &A{}
实现 sort 包的 Interface 接口(len less swap三个方法),然后调用sort.Sort(Interface) 就可以对切片进行排序 swap 方法中可以直接 a,b = b,a 互换
继承有利于复用性和维护性,接口的价值在于设计规范
类型断言
a = b.(Type) 判断接口 b 是否指向 Type 的实例,如果是则转换为 Type 类型并赋值给a,否则会报错
必须完全一致,float32 断言 float64 也会报错
a, flag = b.(Type) 可以接受转换状态,此时不会报错,程序会继续正常执行
1 | var f float32 = 1.1 |
类型判断:a.(type) 会返回a的数据类型,但需要用switch-case进行判断
1 | type Stu struct{} |
文件操作
从数据源(文件)到程序(内存)是输入流,反之是输出流
打开文件: os.Open(name string) (*File, error)
关闭文件 File.Close()
利用缓存读文件:
1 | file2, err2 := os.Open("D:\\test.txt") |
一次性读取文件内容: byteSlice, err := io/ioutil.ReadFile(filename)
一次性写入文件内容: err := io/ioutil.WriteFile(filename, byteSlice, perm)
创建文件、写文件: os.OpenFile(namepath string, flag int, perm filemode) (file *File, err error) flag 是打开模式可以用|组合使用,perm是linux系统限定
bufio.NewWriter(file) 返回writer,调用 WriteString(str)方法,最后调用Flush()方法刷新缓存
判断文件是否存在: os.Sat(path) fileinfo, err 如果err为nil,则存在,如果err用 os.IsNotExist() 判断为true 则不存在,其他错误则不确定
拷贝二进制文件: io.Copy(writer, reader) (written int64, err error)
序列化
JSON,JS对象表示法,由键值对组成 {“name”: value, “name”: [1, 2, 3]} 最外层也可以是数组 [{“name”:val}, {“name”:val2}]
encoding/json.Marshal(interface{}) ( []byte, error ) 序列化变量
在定义结构体字段后加上 json:"name" 可以在序列化时指定键名,比如首字母小写
反序列化: err := json.Unmarshal(byteSlice, *target) 反序列化时target可以不make,但必须传地址,不然改变无法保存
测试
testing 框架可以实现单元测试和性能测试,然后到要测试的包下执行 go test -v 命令开始测试
创建 xxx_test.go 文件,在其中定义 TestXxx(t *testing.T) 函数,如果结果成功则调用 t.Logf(str) 输出信息,否则调用 t.Fatalf(str) 输出信息
测试不需要main方法,由框架调用执行测试函数
测试单个文件而不是整个包: go test -v xxx_test.go xxx.go
测试单个函数: go test -v -test.run TestXxx
goroutine协程 channel管道
进程是程序在操作系统中的一次执行过程,是系统资源分配的基本单位;线程是进程的一个执行实例,是系统调度的最小单位;
多线程程序在单核运行叫并发,多线程程序在多核运行叫并行
协程
GO 主线程相当于程序进程,物理线程,直接作用在CPU上,消耗资源多;协程是轻量级的线程,逻辑态,消耗资源小,可以轻松开启上万个协程。
协程特点:有独立的栈空间,共享程序堆空间,调度由用户控制,协程是轻量级的线程
go fun1() 开启协程
主线程结束,协程即使没有执行完毕也会强制退出
MPG模式:M代表主线程(三角形),P代表协程队列的上下文环境、调度控制(正方形),G代表协程(圆形)。当M0主线程执行的G0协程阻塞(读取文件或数据库)后,会创建新的主线程M1,将M0中等待队列的协程挂到M1下执行。
runtime.NumCPU() 返回当前机器的逻辑CPU数量
runtime.GOMAXPROCS(int) 设置最大的逻辑CPU数量
管道
多个协程同时操作全局变量,要加同步锁,否则会报资源竞争错误
不建议用法: 定义 sync.Mutex 类型全局变量,分别在操作前后用 Lock() Unlock() 方法上锁、解锁,主线程调用 time.sleep() 沉睡一定时间等待协程执行完毕
channel管道:
- 本质是一个先进先出的队列
- 是线程安全的,多协程访问不需要加锁
- 是有类型的,string管道只能放string类型数据
- 是引用类型,必须make初始化后才能放数据
var 变量名 chan 数据类型 变量名 = make(chan 类型, n)
放入数据 intChan<- 10
取出数据 num := <-intChan 取时可以不用变量接收,直接扔掉
存取会改变len(所以不能用普通for循环遍历),不会自动扩容,放满或者空时存取会报错,放满了可以取出再放
使用内置函数close关闭管道后,只能读不能写;管道可以使用for-range遍历,但是必须关闭才能遍历,否则报错deadlock
读取和写入时,如果为空或满,会检测有没有对应的发送方或者接收方,如果没有就会报死锁,如果有,则会阻塞该协程,等待对方发送或读取数据后再激活继续操作(消费者生产者模式)。关闭管道后,为空时读取不会报死锁,会返回false,告诉读取方放入结束
管道可以声明为只读 var chan1 chan<- int 或只写 var chan1 <-chan int, 但是并没有改变数据类型。可以标注在函数参数上,防止函数内误操作
如果不知道何时关闭又想遍历,可以用select。每一次select,如果1管道没有关闭,就会判断下一个case,一直到default
1 | label: |
协程中使用recover可以解决协程报错,导致主线程终止的问题
1 | func Goroutine1(){ |
反射
反射可以在运行时动态获取变量的各种信息,如类型(Type)、类别(Kind),对于结构体可以获取结构体本身的信息,如字段、方法等;使用反射,可以修改变量的值,可以调用关联方法
reflect包实现了反射,使用TypeOf可以返回一个Type接口类型值,使用ValueOf可以返回一个Value类型值,使用Zero传入一个Type类型值,可以返回一个代表该类型零值的Value类型对象
变量、interface{}、Value可以相互转换:
- interface{} -> Value v := reflect.ValueOf(i)
- value -> interface{} i := v.interface()
- interface -> 变量 b := i.(变量类型) 类型断言
Value类和Type接口的Kind()方法会返回kind常量,kind类别与type类型可能相同也可能不同,int类型都为int,但是结构体type为包名.类型,kind为struct
Value.Int()方法可以获取int变量的值,其他类型同理,用错类型会报panic
ValueOf(&变量).Elem().SetInt(int) 改变变量的值,ValueOf()需要传入变量的地址&,此时得到的value的类别是ptr,所以要先Elem()再改
Value.Method(int)传入方法0开始的排序序号,可以获取到方法,通过Call()传入value切片作为参数,返回结果value切片
Value.NumField()可以获取字段个数
Value.Field(int) 可以获取该字段的Value,Type.Value(int) 可以返回该字段的 StructField,StructField.Tag.Get(“json”)可以获取之前为序列化写的Tag
Value.NumMethod()可以获取方法个数
Value.Method(int) 获取数量
Value.Method(int).Call(参数) 调用方法,参数和返回值都是Value切片,注意方法是按照名字而非定义顺序排序
如果要修改地址,仍然要传入地址,且上述方法必须调用value.Elem()再调用
用指针获取的Type也是指针类别,仍然要Elem()
reflect.New(type)可以获取一个指向该类型的零值的指针Value,类别也是指针
网络编程
0是保留端口,1-1024是固定端口,1025-65535是动态端口
服务器监听:
net.Listen(“tcp”,”127.0.0.1:8888”) 返回一个Listener接口和err
Listener接口有Accept()方法等待连接,等待后返回Conn接口和err
Listener接口需要Close()
客户端连结:
net.Dial(“tcp”,”127.0.0.1:8888”) 返回Conn接口和err
从终端输入数据:reader := bufio.NewReader(os.Stdin)
str, err := reader.ReadString(‘\n’)
sendNum, err := conn.Write([]byte(str)) 发送给服务器
服务器接受:
accept以后创建一个协程处理连结
getNum, err := conn.Read(buff []byte) 等待发送,如果客户端没有write,就会一直阻塞
fmt.Print(string(buff[:n])) 客户端发送数据包括\n
conn.Close() 关闭连结
Redis
NoSQL数据库,既可以存放在内存中,又可以持久化
可以存放string键值对,hash (哈希,类似于map),list (列表,双向队列?),set集合,zset有序集合
安装好后默认有0-15共16个数据库
指令:
- keys * 查看当前数据库所有键值
- select index 切换数据库
- dbsize 查看数据库数量
- flushdb flushall 清空所有数据库
字符串
strings 是二进制安全的,可以存放图片等,value最大512M
指令:
- set key value 设置键值对
- get key 获取对应值
- del key 删除
- setex key seconds value 创建/修改键值,同时设置有效时间
- expire key seconds 设置有效时间
- mset key value [key value key value…] 一次设置多个key-value
- mget key [key…] 一次获取多个值
值有空格时要加引号包裹
哈希
哈希是多个字符串类型field-value对的集合
- hset key field value [field value…] 设置哈希值
- hget key field 获取域值
- hgetall key 获取所有域和值
- hmset key field value [field value…] 一次设置多个值
- hmget key field [fiedl…] 一次获取多个值
- hlen key 统计一个哈希有几个元素
- hdel key 删除哈希
列表
底层为字符串链表,是有序的,值可以重复,可以从首部和尾部插入
- lpush key value [value value …] 从左插入值
- rpush key value … 从右插入值
- lrange key start stop 从start开始读取值到stop结束,下标从0开始,最后一个下标为-1,不会删除这些值
- lpop key 从左边读取值并删除
- rpop key 从右边读取值并删除
- del key 删除列表
- lindex key index 按照索引下标获取元素
- llen key 返回长度,没有则为0
集合
字符串集合,无序不重复
- sadd key value… 放入值,已有则返回0
- smembers key 获取所有值
- sismember key value 判断是否是成员
- srem key value 删除成员
GO 连结redis
安装第三方包:go get github.com/garyburd/redigo/redis
redis 6 新版:go get github.com/go-redis/redis/v8
示例:
1 | package main |
操作哈希,只要修改具体指令即可:con.Do("HSet", "key", "field", "value")redis.String(con.Do("HGet", "key", "field"))
可以使用MSet MGet 一次操作多个,使用redis.Strings()转换
1 | //连结数据库操作省略 |
设置有效时间
_, err := con.Do(“expire”, “key”, seconds)
操作列表
_, err := con.Do(“lpush”, “fruits”, “apple”, “banana”, “orange”, “mongo”)
r, err := redis.String(con.Do(“rpush”, “fruits”))